ASCII, Unicode e UTF-8: diferenças com exemplos práticos
Distinga carateres, pontos de código e bytes. Um guia prático de ASCII, Unicode e UTF-8 para diagnosticar texto corrompido sem confundir as camadas.
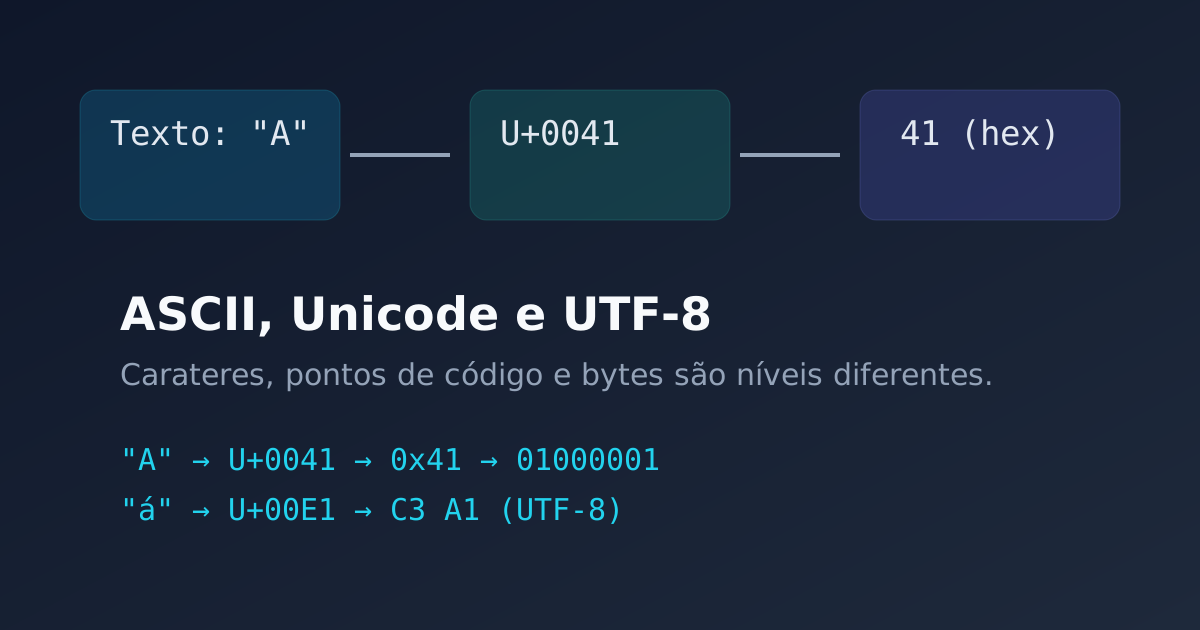
ASCII, Unicode e UTF-8 aparecem muitas vezes na mesma conversa, mas não designam a mesma coisa. A distinção é essencial ao investigar texto ilegível, símbolos substituídos por U+FFFD ou dados que mudam ao passar entre uma API, uma base de dados e um ficheiro.
Em resumo:
- ASCII é um conjunto codificado de 128 carateres com valores de 0 a 127.
- Unicode atribui pontos de código a carateres e outros elementos de texto.
- UTF-8 transforma pontos de código Unicode numa sequência de bytes.
Três camadas que não devem ser confundidas
Considere a letra A:
- O caráter visível é
A. - O ponto de código Unicode é
U+0041. - Em UTF-8, o byte é
41em hexadecimal, ou01000001em binário.
Agora considere 中:
- O caráter visível é
中. - O ponto de código é
U+4E2D. - Em UTF-8, os bytes são
E4 B8 AD.
Um ponto de código não é, por si só, um byte. Também não é correto afirmar que todos os carateres ocupam oito bits. Os carateres ASCII ocupam um byte em UTF-8; outros pontos de código podem ocupar dois, três ou quatro bytes.
Onde entra o ASCII
ASCII continua presente em protocolos, formatos de texto, terminais e linguagens de programação. O conjunto inclui letras latinas sem acentos, algarismos, pontuação e carateres de controlo. O valor 65 corresponde a A, mas o padrão é de 7 bits; a apresentação 01000001 acrescenta um zero inicial para mostrar o valor num byte.
UTF-8 preserva esta zona: os valores ASCII de 0 a 127 usam os mesmos bytes. Esta compatibilidade explica por que motivo um ficheiro ASCII válido também é UTF-8 válido.
O que o Unicode resolve
Unicode fornece um repertório e regras comuns para texto de vários sistemas de escrita, símbolos e emoji. O padrão distingue carateres abstratos de representações concretas. Uma letra visível pode ainda ser composta por mais de um ponto de código, como uma letra seguida de um sinal combinante.
UTF-8 e UTF-16 são formas diferentes de codificar o mesmo espaço de pontos de código. Em JavaScript, as cadeias de texto são observadas através de unidades de código UTF-16; isto explica por que razão alguns emoji contam como duas unidades em length, apesar de serem um único ponto de código.
Diagnóstico de texto corrompido
Quando aparece mojibake, confirme a sequência completa:
- Identifique a codificação original do ficheiro ou da resposta.
- Verifique o cabeçalho HTTP, por exemplo:
Content-Type: text/html; charset=utf-8- Confirme a codificação da ligação e das colunas da base de dados.
- Evite descodificar os mesmos bytes duas vezes.
- Compare os bytes em hexadecimal antes e depois de cada etapa.
- Confirme que a fonte possui um glifo para o caráter; a ausência de glifo não altera o ponto de código.
Uma sequência que apresente separadamente os valores U+00C3 e U+00A1 no lugar de á, por exemplo, costuma indicar que bytes UTF-8 foram interpretados como outra codificação de oito bits. Alterar o tipo de letra não corrige esse erro: é necessário interpretar novamente os bytes com a codificação correta.
Teste prático no navegador
Use o conversor de texto para binário para comparar A, á, € e 😀. Depois recupere o texto com o conversor de binário para texto. Para transportar os mesmos bytes em texto ASCII, experimente o codificador e descodificador Base64.
O teste de ida e volta deve preservar o texto, mas só quando as duas direções usam a mesma codificação. Base64 não escolhe uma codificação de carateres e não encripta os dados; apenas representa bytes. Para decidir se essa representação faz sentido no seu caso, consulte quando usar Base64.